Anthropic hat Claude Opus 5.5 am 22. September 2026 veröffentlicht. Naheliegend ist die Frage, ob es GPT-6 Astra schlägt. Aufschlussreicher ist der Preis.
Günstiger und schneller
Laut Anthropic (22.09.2026) kostet Opus 5.5 4 Dollar je Million Eingabe-Tokens und 20 Dollar je Million Ausgabe-Tokens. Bei Opus 5 waren es 5 und 25 Dollar. Anthropic fasst das als 40 % geringere Kosten bei typischen Arbeitslasten zusammen, dazu kommt eine um mehr als 30 % schnellere Ausgabe. Das Lesen aus dem Cache sinkt von 0,50 auf 0,20 Dollar, das Schreiben in den Cache von 6,25 auf 5 Dollar.
Das klingt nach einer Fußnote für Entwickler, hat aber Folgen. Wird ein Spitzenmodell besser und gleichzeitig billiger, verschiebt sich, was sich damit lohnt: mehr KI-gestützte Arbeit für jeden Euro, mehr Anfragen, mehr Anwendungen, die bisher zu teuer waren. Wer das Tempo über das Sparen stellt, kann in Claude Code und auf der Claude Platform einen Fast Mode nutzen, laut Anthropic bis zu 2,5-mal so schnell, zu 8 Dollar Eingabe und 40 Dollar Ausgabe.
Preise im Vergleich zu Opus 5 (je 1 Mio. Tokens, laut Anthropic, 22.09.2026)
| Eingabe | Ausgabe | Cache lesen | Cache schreiben | |
|---|---|---|---|---|
| Opus 5.5 | 4 $ | 20 $ | 0,20 $ | 5 $ |
| Opus 5 | 5 $ | 25 $ | 0,50 $ | 6,25 $ |
| Opus 5.5 Fast Mode | 8 $ | 40 $ | – | – |
Wo das Modell vorne liegt
In den Benchmarks, die Anthropic selbst veröffentlicht hat (22.09.2026), führt Opus 5.5 in den meisten Kategorien. Bei Terminal-Bench 4.0, einem Test für agentisches Programmieren, erreicht es 66,4 %, gegenüber 52,3 % für Opus 5, 57,9 % für GPT-6 Astra und 55,8 % für Fable 5.1. Bei Humanity's Last Exam mit Werkzeugzugriff sind es 67,7 % gegenüber 63,6 %, bei GDPval-AA v2.1, einem Maß für Wissensarbeit, 1846 gegenüber 1708 Elo-Punkten.
In OSWorld 2.1, einem Test für die selbstständige Bedienung eines Computers (Programme öffnen, Oberflächen bedienen, Aufgaben ohne festes Drehbuch erledigen), kommt Opus 5.5 auf 81,8 %, Opus 5 auf 74,0 %. Anthropic kennzeichnet diese Werte als „partial“.
Zwei Beispiele nennt Anthropic: Ein früher Tester schloss eine Code-Migration über 680.000 Zeilen in weniger als einem Tag ab, eine Arbeit, für die ein Entwicklerteam Wochen gebraucht hätte. Und in einem internen Test übersetzte Opus 5.5 die Software HAProxy von C nach Rust in 9,5 Stunden, Fable 5.1 brauchte 12 Stunden, bei 51 % geringeren Kosten. Das sind Einzelfälle und kein Durchschnitt. Sie zeigen, welche Art von Aufgabe profitiert, nicht wie stark jede Aufgabe profitiert.
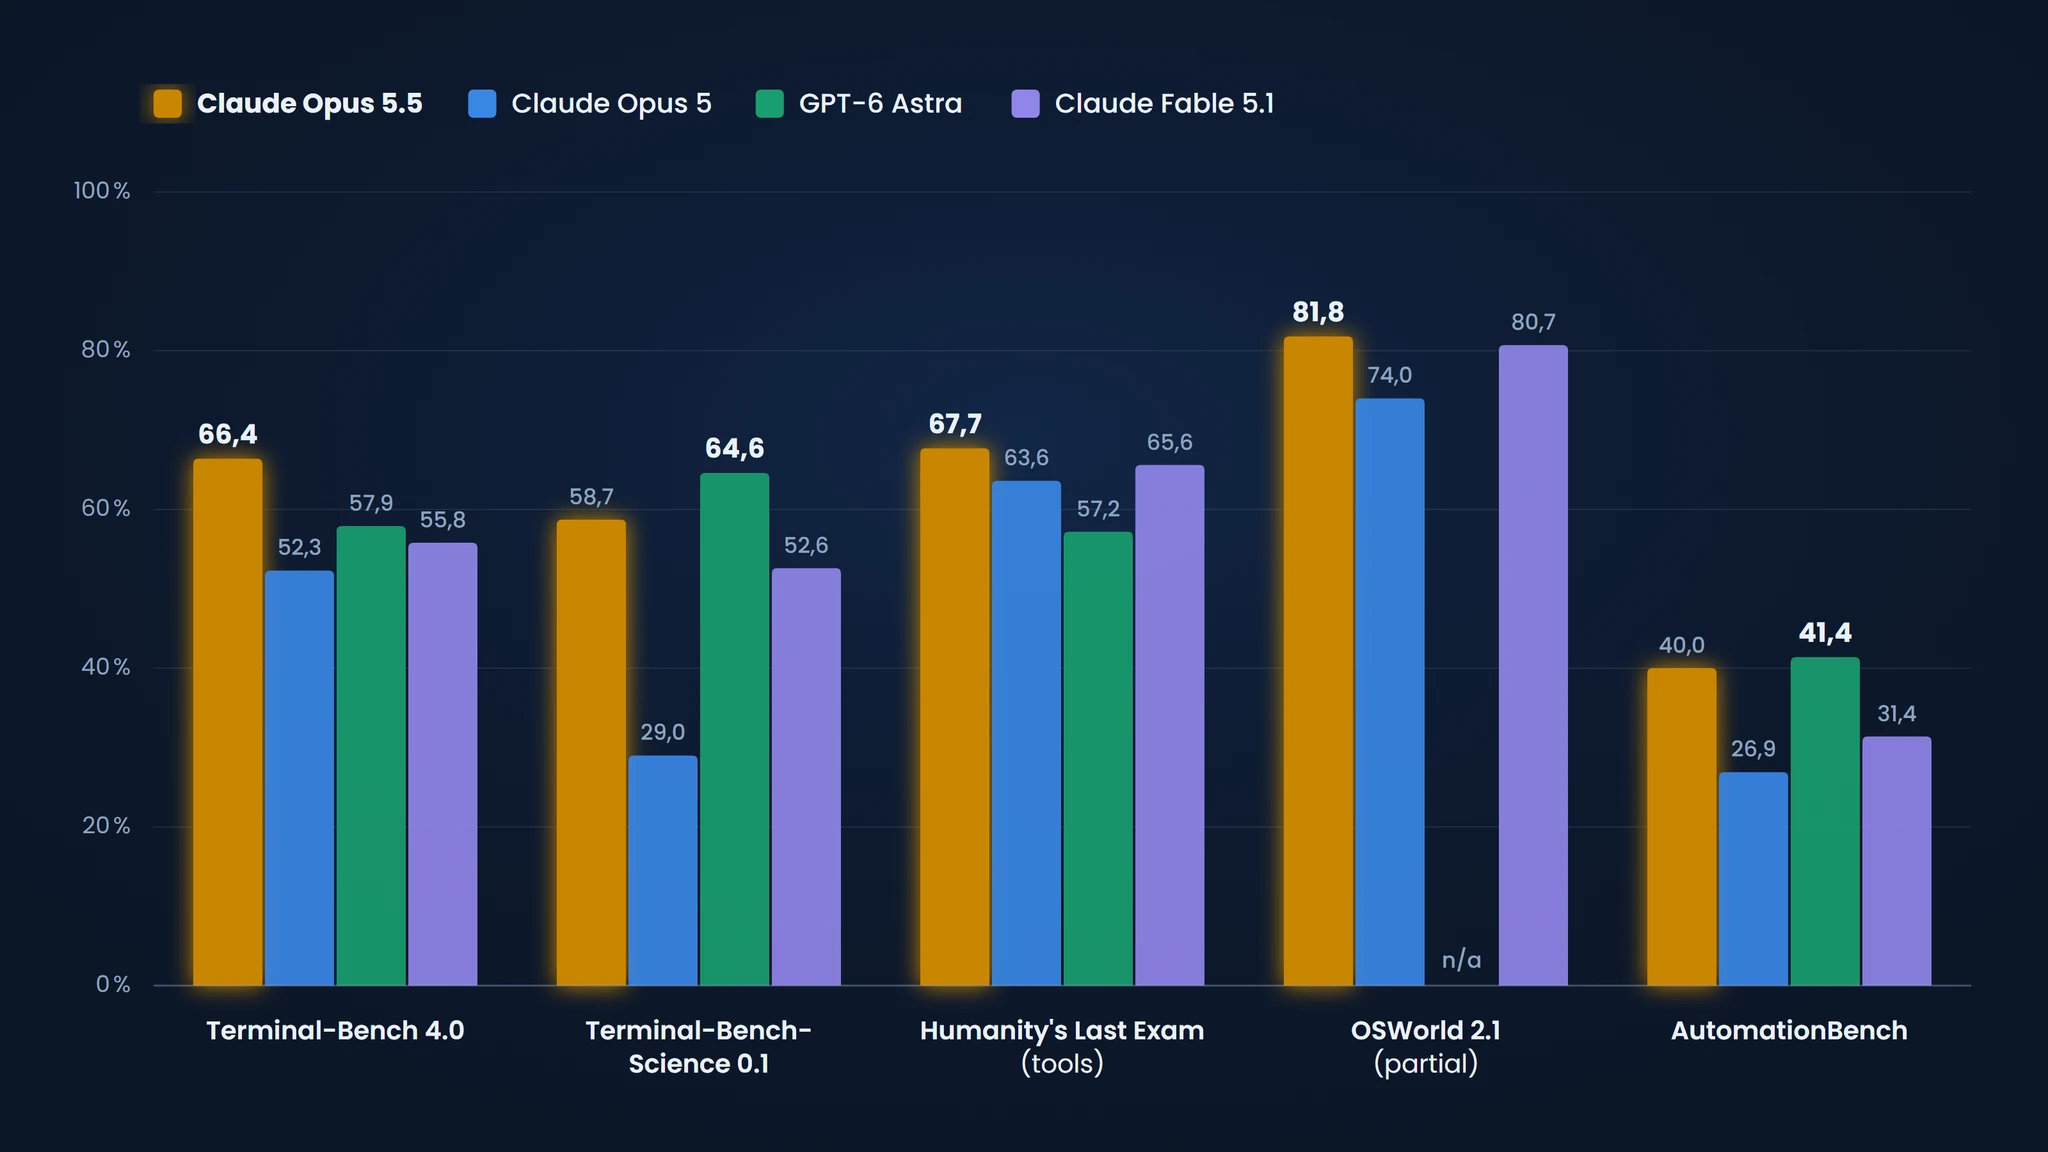
Benchmark-Vergleich (laut Anthropic, 22.09.2026)
| Benchmark | Opus 5.5 | Opus 5 | GPT-6 Astra | Fable 5.1 |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 66,4 % | 52,3 % | 57,9 % | 55,8 % |
| Terminal-Bench-Science 0.1 | 58,7 % | 29,0 % | 64,6 % | 52,6 % |
| Humanity's Last Exam (mit Werkzeugen) | 67,7 % | 63,6 % | 57,2 % | 65,6 % |
| OSWorld 2.1 (partial) | 81,8 % | 74,0 % | n/a | 80,7 % |
| AutomationBench | 40,0 % | 26,9 % | 41,4 % | 31,4 % |
| GDPval-AA v2.1 (Elo) | 1846 | 1708 | 1542 | 1735 |
Was ein Hersteller ungern zeigt
In zwei dieser Benchmarks liegt GPT-6 Astra vorn. In AutomationBench, einem Test für Geschäftsprozesse, erreicht es 41,4 %, Opus 5.5 40,0 %. Diesen Test hat laut Anthropic Zapier gerechnet, ohne Ausweichmodelle, sodass jeder Eingriff einer Sicherheitsvorkehrung als Fehler zählte. In Terminal-Bench-Science 0.1 ist der Abstand größer: 64,6 % für Astra, 58,7 % für Opus 5.5. Anthropic veröffentlicht beide Zahlen selbst, und sie gehören in jede ehrliche Darstellung des Starts. Kein Spitzenmodell gewinnt mehr in allen Kategorien, und die Abstände an der Spitze werden insgesamt kleiner.
Sicherheit, der unterschätzte Teil
Laut Anthropic schneidet Opus 5.5 in seinem automatisierten Verhaltensaudit über knapp 2.000 Szenarien besser ab als jedes jüngere Claude-Modell, bei fast jeder Kennzahl für Fehlverhalten. In einem neuen Test versuchte es rund 85 % seltener als Opus 5 oder Claude Mythos 5.1, festgelegte Grenzen zu umgehen. Bei Prompt-Injection teilt es sich in einem Benchmark der Sicherheitsfirma Gray Swan mit Fable 5.1 die niedrigste Erfolgsquote aller getesteten Modelle. Vor dem Start haben unter anderem METR und Frontier Design das Modell extern getestet. Es trägt ein Wasserzeichen nach den Vorgaben der EU-KI-Verordnung, und der Denkmodus lässt sich nicht mehr abschalten.
Unser eigener Test
Neben den Benchmarks von Anthropic haben wir selbst getestet. Am 24. September 2026 haben wir Opus 5.5 über unseren Zugang bei OpenRouter eine typische Rechenaufgabe aus dem Geschäftsalltag gestellt: den Verkaufspreis eines Kleidungsstücks zu 89 € mit 30 % Marge, angepasst an einen Wettbewerber, der 15 % günstiger ist. Das Modell antwortete in 5,8 Sekunden richtig. Das ist eine einzelne Stichprobe und kein Benchmark, aber genau die Art Aufgabe, für die wir solche Modelle wirklich einsetzen.
Erste Reaktionen
Nach dem Start am 22. September 2026 war der Ton in der Diskussion auf Hacker News (über 800 Kommentare) und im Subreddit r/ClaudeCode deutlich freundlicher als bei Opus 5. Am häufigsten ging es um den Stil, weniger um die Leistung: Mehrere Kommentatoren beschreiben Opus 5.5 als direkter und weniger weitschweifig als den Vorgänger, manche halten es deshalb schon für alltagstauglich. Genau das hatte man Opus 5 abgesprochen.
Das ist die Stimmung in den Foren in den ersten 48 Stunden und keine Messung. Wir geben sie als ersten Eindruck wieder.
Nachtrag vom 28. September 2026: Sonnet 5.5 bestätigt die These sechs Tage später
Anthropic hat Claude Sonnet 5.5 am 28. September 2026 veröffentlicht, sechs Tage nach Opus 5.5, und es stützt die Überlegung oben. Sonnet 5.5 kostet 2 Dollar je Million Eingabe-Tokens und 10 Dollar je Million Ausgabe-Tokens, halb so viel wie Opus 5.5, und bleibt in den gemeinsamen Benchmarks in Reichweite des Spitzenmodells. In Terminal-Bench 4.0 erreicht Sonnet 5.5 70,6 % und übertrifft damit die 66,4 % von Opus 5.5. In GDPval-AA v2.1 liegen beide gleichauf (1844 gegenüber 1846), bei Humanity's Last Exam mit Werkzeugen liegt Sonnet 5.5 leicht zurück (64,5 % gegenüber 67,7 %). Laut Anthropic gibt es seine Ausgabe mehr als 30 % schneller aus als Sonnet 5 und kostet je Aufgabe bis zu 30 % weniger.
Dass ein günstigeres Modell derselben Familie das Spitzenmodell binnen einer Woche einholt, ist der Trend dieses Artikels, nur schneller als erwartet. Für eine Marke folgt daraus dasselbe, nur deutlicher: Das Modell, das antwortet, wechselt weiter, manchmal innerhalb weniger Tage. Beobachten sollte man deshalb, ob die eigene Marke in der Antwort vorkommt, und weniger, welches Modell sie geschrieben hat.
Was das für deine Sichtbarkeit bedeutet
Ein besseres und günstigeres Spitzenmodell bedeutet mehr Anfragen an KI-Systeme und mehr Vertrauen in ihre Antworten. Für eine Marke ist „Welches Modell gewinnt?“ deshalb die falsche Frage. Die richtige lautet, ob deine Marke in den Antworten dieser Modelle vorkommt, egal welches gerade vorne liegt.
Genau das verschiebt sich mit jeder neuen Modellgeneration. Wer nur ein System beobachtet, sieht nicht, was seine Kunden lesen, wenn sie ChatGPT, Gemini, Claude oder Perplexity fragen. An der Spitze wechseln die Modelle. Ob deine Marke in der Antwort steht, bleibt die Frage, gleich welches Modell antwortet.
Häufige Fragen
Was ändert sich bei Claude Opus 5.5 gegenüber Opus 5?
Es kostet bei typischen Arbeitslasten 40 % weniger, gibt seine Antworten mehr als 30 % schneller aus und schneidet in fast allen Benchmarks besser ab, die Anthropic am 22.09.2026 veröffentlicht hat, vom agentischen Programmieren bis zur selbstständigen Bedienung eines Computers.
Wie viel günstiger ist Opus 5.5?
Laut Anthropic kostet die Eingabe 4 Dollar je Million Tokens (vorher 5) und die Ausgabe 20 Dollar (vorher 25). Das Lesen aus dem Cache sinkt von 0,50 auf 0,20 Dollar.
Ist Opus 5.5 besser als GPT-6 Astra?
In den meisten Benchmarks, die Anthropic zeigt, ja. Astra führt in zwei: in AutomationBench mit 41,4 % gegenüber 40,0 % (einem Test, den laut Anthropic Zapier ohne Ausweichmodelle gerechnet hat) und in Terminal-Bench-Science 0.1 mit 64,6 % gegenüber 58,7 %.
Was bedeutet ein günstigeres Spitzenmodell für die Sichtbarkeit meiner Marke?
Mehr Anfragen an KI-Systeme und mehr Vertrauen in ihre Antworten. Wichtiger als die Frage, welches Modell gewinnt, wird dann, ob deine Marke in den Antworten vorkommt, gleich welches Modell gerade vorne liegt.
Kann ich Opus 5.5 schon nutzen?
Ja. Laut Anthropic ist es seit dem 22. September 2026 auf allen Plattformen verfügbar, auch über Amazon Web Services, Google Cloud und Microsoft Azure.
Wie schneidet Opus 5.5 im Vergleich zu Claude Sonnet 5.5 ab?
Sonnet 5.5, veröffentlicht am 28. September 2026, kostet die Hälfte (2 Dollar Eingabe und 10 Dollar Ausgabe je Million Tokens statt 4 und 20) und bleibt in den gemeinsamen Benchmarks nah an Opus 5.5. In Terminal-Bench 4.0 liegt es vorn (70,6 % gegenüber 66,4 %), in GDPval-AA v2.1 gleichauf (1844 gegenüber 1846) und bei Humanity's Last Exam mit Werkzeugen leicht dahinter (64,5 % gegenüber 67,7 %).
Quelle: Anthropic, offizielle Ankündigung von Claude Opus 5.5, 22. September 2026 (https://www.anthropic.com/claude-opus-5-5), und von Claude Sonnet 5.5, 28. September 2026 (https://www.anthropic.com/claude-sonnet-5-5).
