Anthropic publicó Claude Opus 5.5 el 22 de septiembre de 2026. La pregunta obvia es si supera a GPT-6 Astra. La pregunta más útil es otra, y tiene que ver con el precio.
Más barato y más rápido
Según Anthropic, 22.09.2026, Opus 5.5 cuesta 4 dólares por millón de tokens de entrada y 20 dólares por millón de salida, frente a los 5 y 25 dólares de Opus 5. La propia Anthropic lo resume así: «un 40% menos en cargas de trabajo típicas», junto con una salida un 30% más rápida. La lectura de caché baja de 0,50 a 0,20 dólares, la escritura de caché de 6,25 a 5 dólares.
Parece un detalle técnico. No lo es. Cuando un modelo de frontera mejora y se abarata al mismo tiempo, cambia lo que compensa hacer con él: más trabajo asistido por IA por cada euro, más consultas, más casos de uso que antes salían demasiado caros. Anthropic también ofrece una variante Fast-Mode a 8 dólares de entrada y 40 de salida, una opción aparte para quien prefiera cambiar parte de ese ahorro por más velocidad.
Precios frente a Opus 5 (por 1M de tokens, según Anthropic, 22.09.2026)
| Entrada | Salida | Lectura caché | Escritura caché | |
|---|---|---|---|---|
| Opus 5.5 | 4 $ | 20 $ | 0,20 $ | 5 $ |
| Opus 5 | 5 $ | 25 $ | 0,50 $ | 6,25 $ |
| Opus 5.5 modo rápido | 8 $ | 40 $ | — | — |
Dónde rinde mejor
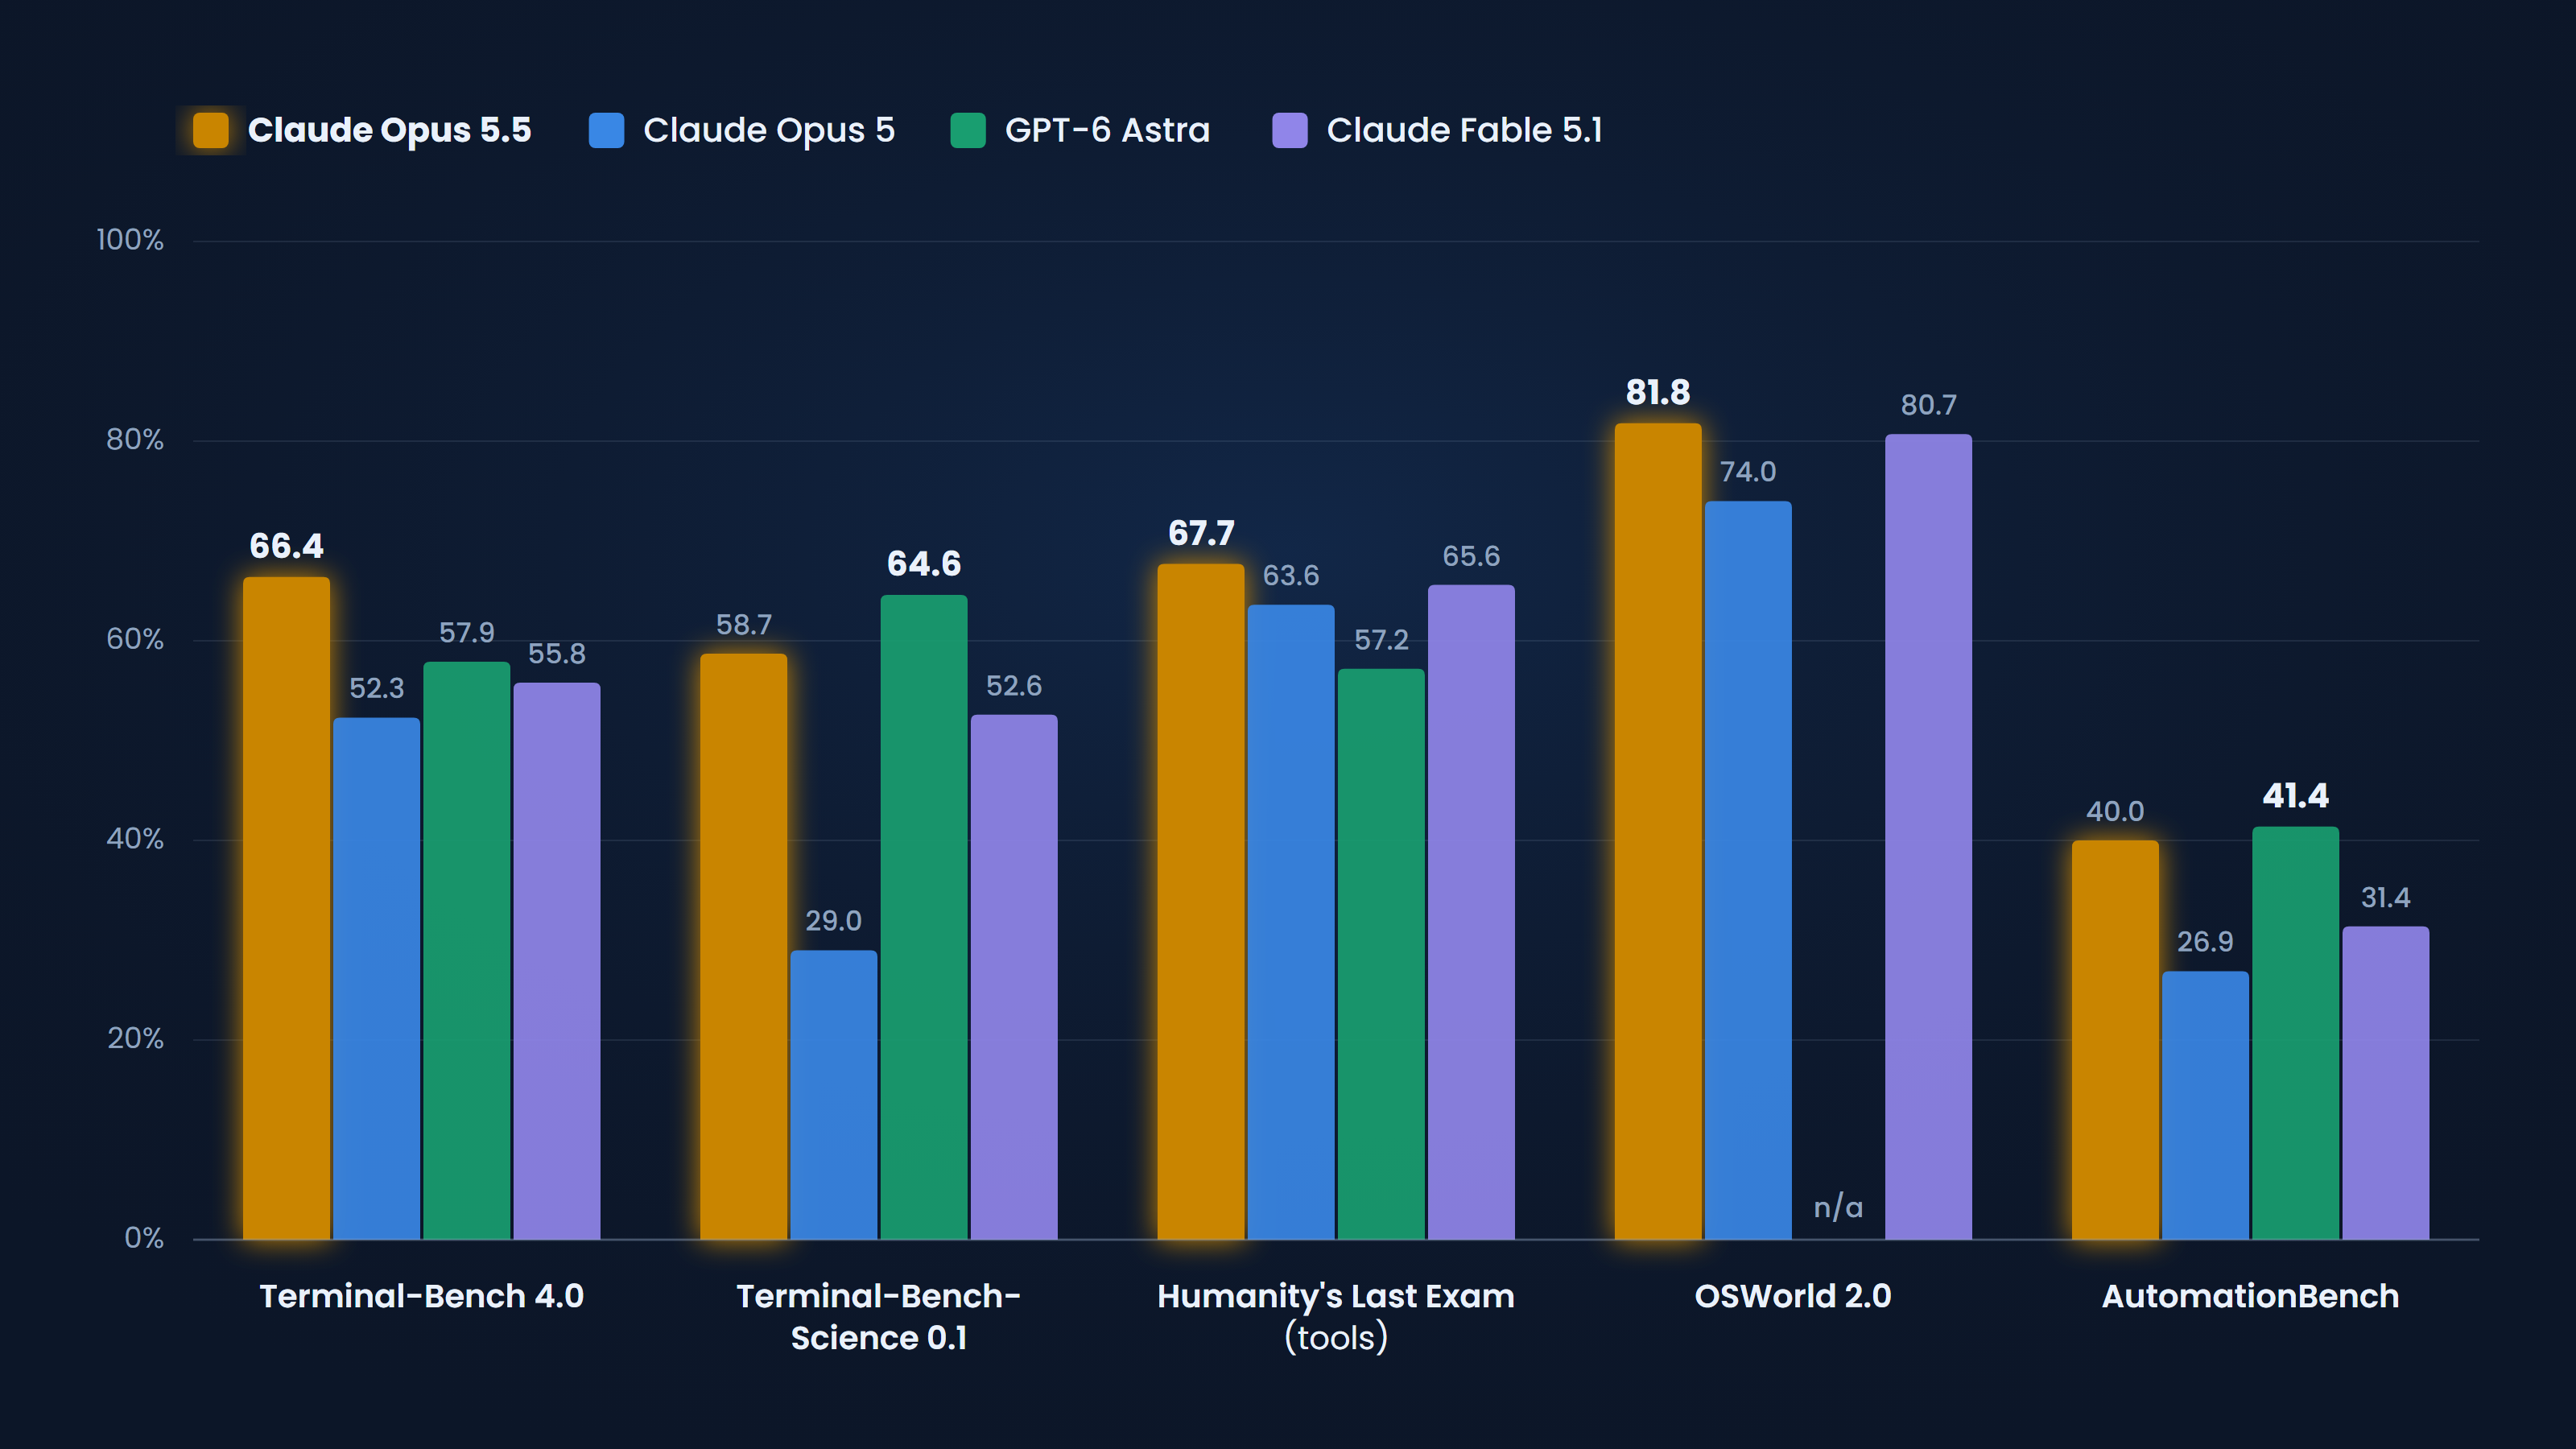
En los benchmarks que la propia Anthropic publicó (22.09.2026), Opus 5.5 lidera en la mayoría de categorías. Terminal-Bench 4.0, una prueba de programación agéntica: 66,4% frente al 52,3% de Opus 5, el 57,9% de GPT-6 Astra y el 55,8% de Fable 5.1. Humanity’s Last Exam con acceso a herramientas: 67,7%, frente al 63,6% de Opus 5. GDPval-AA v2.1, una medida de trabajo de conocimiento: 1846 Elo frente a 1708.
En OSWorld 2.0, una prueba de uso autónomo de ordenador (abrir aplicaciones, navegar interfaces, completar tareas sin guion previo), Opus 5.5 llega al 81,8%, frente al 74,0% de Opus 5.
Anthropic lo ilustra con dos ejemplos: una migración de código de 680.000 líneas completada en un día en lugar de semanas, y la conversión de HAProxy de C a Rust en 9,5 horas, con un 51% menos de coste que con Fable 5.1. Son casos concretos, no una media: sirven para mostrar qué tipo de tarea se beneficia, no cuánto se beneficia cualquier tarea.
Comparación de benchmarks (según Anthropic, 22.09.2026)
| Benchmark | Opus 5.5 | Opus 5 | GPT-6 Astra | Fable 5.1 |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 66,4 % | 52,3 % | 57,9 % | 55,8 % |
| Terminal-Bench-Science 0.1 | 58,7 % | 29,0 % | 64,6 % | 52,6 % |
| Humanity’s Last Exam (tools) | 67,7 % | 63,6 % | 57,2 % | 65,6 % |
| OSWorld 2.0 | 81,8 % | 74,0 % | n/a | 80,7 % |
| AutomationBench | 40,0 % | 26,9 % | 41,4 % | 31,4 % |
| GDPval-AA v2.1 (Elo) | 1846 | 1708 | 1542 | 1735 |
La parte que a un fabricante no le gusta enseñar
GPT-6 Astra lidera en dos de estos benchmarks. En AutomationBench, una prueba de procesos empresariales, marca 41,4% frente al 40,0% de Opus 5.5, y Anthropic precisa que Opus 5.5 corrió esa prueba sin modelos de respaldo (fallback). En Terminal-Bench-Science 0.1 la distancia es mayor: 64,6% de Astra frente al 58,7% de Opus 5.5. Anthropic publica ambas cifras por su cuenta, y pertenecen a cualquier relato honesto sobre el lanzamiento: ningún modelo de frontera gana ya en todas las categorías, y la distancia entre los modelos punteros se está reduciendo en general.
Seguridad, la parte que se subestima
Según Anthropic, Opus 5.5 es su modelo con mejor resultado hasta ahora en una auditoría automatizada de comportamiento sobre unos 2.000 escenarios. Los intentos de traspasar límites definidos ocurren un 85% menos que con Opus 5 o Mythos 5.1. En resistencia a inyección de prompts, iguala a Fable 5.1, la tasa de éxito más baja registrada hasta ahora. Las pruebas externas corrieron a cargo de METR y Frontier Design, incluye una marca de agua conforme al Reglamento de IA de la UE, y el modo de razonamiento no se puede desactivar.
Nuestra propia prueba
Además de repasar los benchmarks de Anthropic, hicimos la nuestra: el 24 de septiembre de 2026 consultamos Opus 5.5 a través de nuestro acceso por OpenRouter con un cálculo típico de negocio, el precio de venta de una prenda a 89 € con un margen del 30%, ajustado frente a un competidor un 15% más barato. El modelo respondió correctamente en 5,8 segundos. Es una sola muestra, no un benchmark, pero es el tipo de tarea que de verdad hacemos con estos modelos.
Primeras reacciones
Tras el lanzamiento del 22 de septiembre de 2026, la discusión en Hacker News (más de 800 comentarios) y en Reddit r/ClaudeCode mostró un tono claramente más positivo que con Opus 5. El tema que más se repite es el estilo, más que el rendimiento en sí: varios comentaristas describen Opus 5.5 como más directo y menos verboso que su predecesor, hasta el punto de que algunos ya lo consideran apto para uso diario, justo lo que se le reprochaba a Opus 5.
Esto es el ánimo de los foros en las primeras 48 horas, no una medición, y lo recogemos como eso: una primera impresión, no una prueba.
Qué significa esto para tu visibilidad
Un modelo de frontera mejor y más barato significa más consultas hacia los sistemas de IA, no menos, y más confianza depositada en sus respuestas. Para una marca, «qué modelo gana» es la pregunta equivocada. La correcta es si tu marca aparece en las respuestas que dan estos modelos, sea cual sea el que lidere esa semana.
Eso es lo que cambia con cada nueva generación de modelos. Quien solo vigila un sistema no ve lo que realmente leen sus clientes cuando preguntan a ChatGPT, Gemini, Claude o Perplexity. Los modelos se turnan en la cabeza. La pregunta de si tu marca aparece en la respuesta sigue siendo la misma, la responda el que la responda.
Preguntas frecuentes
¿Qué cambia en Claude Opus 5.5 respecto a Opus 5?
Cuesta un 40% menos en cargas de trabajo típicas, responde un 30% más rápido y mejora en casi todos los benchmarks que Anthropic ha publicado (22.09.2026), desde programación agéntica hasta uso autónomo de ordenador.
¿Cuánto más barato es Opus 5.5?
Según Anthropic, la entrada cuesta 4 dólares por millón de tokens (antes 5) y la salida 20 dólares (antes 25). La lectura de caché baja de 0,50 a 0,20 dólares.
¿Es Opus 5.5 mejor que GPT-6 Astra?
En la mayoría de los benchmarks que Anthropic ha mostrado, sí. Astra lidera en dos: AutomationBench, con un 41,4% frente al 40,0% (una prueba que, según Anthropic, Opus 5.5 corrió sin modelos de respaldo), y Terminal-Bench-Science 0.1, con un 64,6% frente al 58,7%.
¿Qué significa un modelo de frontera más barato para la visibilidad de mi marca?
Más consultas y más confianza en las respuestas de los sistemas de IA. La pregunta que importa deja de ser qué modelo gana y pasa a ser si tu marca aparece en las respuestas que dan, sea cual sea el que lidere.
¿Puedo usar Opus 5.5 ya?
Sí, está disponible en las plataformas principales de Anthropic desde el 22 de septiembre de 2026.
Versión en inglés de este artículo: runtruffle.com/blog/claude-opus-5-5.
Fuente: Anthropic, anuncio oficial de Claude Opus 5.5, 22 de septiembre de 2026 (https://www.anthropic.com/claude-opus-5-5).