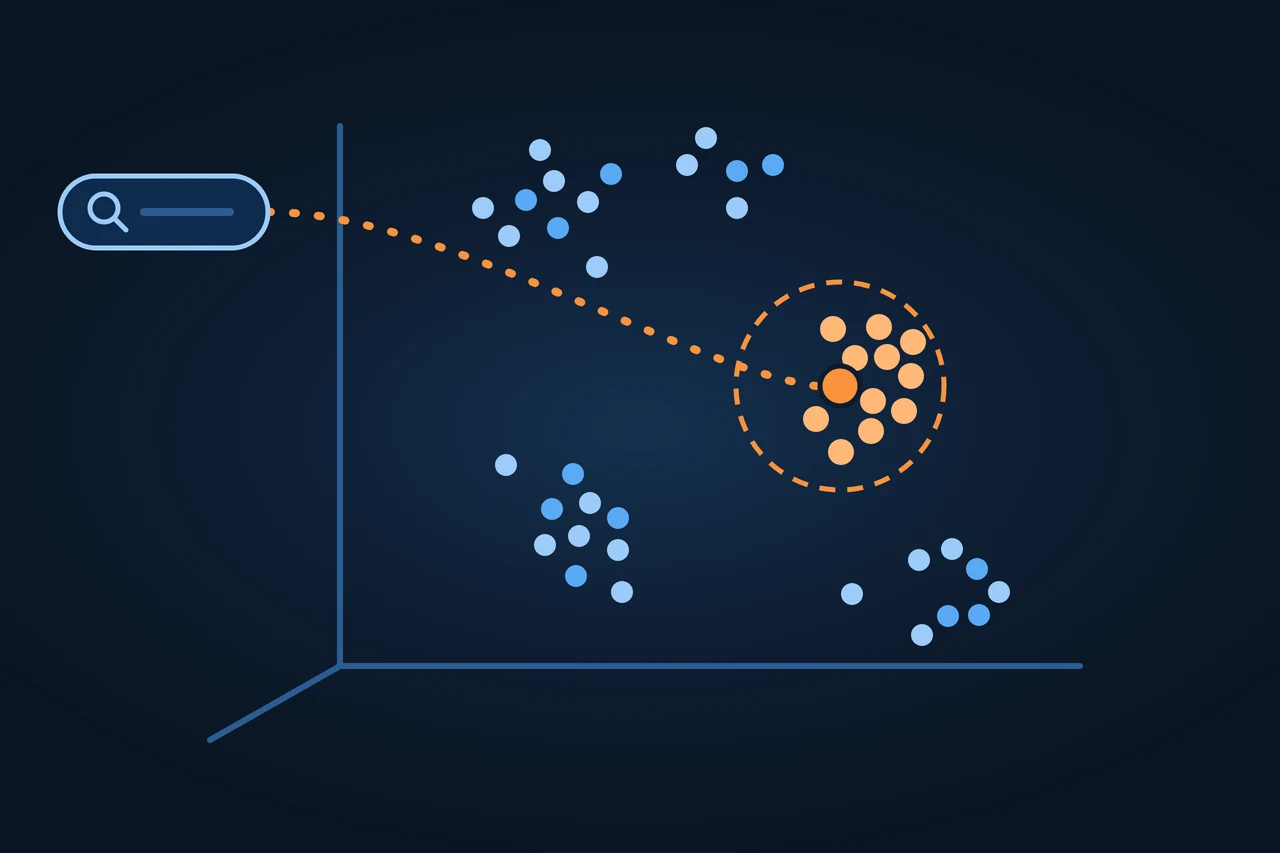
Eine Vektordatenbank (englisch vector database) speichert Vektoren, meist Embeddings von Texten, Bildern oder Audio, und durchsucht sie nach Ähnlichkeit statt nach exakten Werten. Weaviate definiert sie als Datensystem, das Vektor-Embeddings speichert, indexiert und abfragt. Laut Weaviate und Pinecone kommen zur Ähnlichkeitssuche die Funktionen jeder Datenbank hinzu: Daten einfügen, ändern und löschen, nach Metadaten filtern und Zugriffe regeln.
Eine Vektordatenbank speichert Embeddings und sucht nach Ähnlichkeit. Wie sie funktioniert, was sie von Index und Bibliothek trennt, wann sie unnötig ist.
Geschichte und Entwicklung
Die Technik dahinter hat diese Stationen:
30. März 2016: Yu. A. Malkov und D. A. Yashunin veröffentlichen auf arXiv HNSW, einen Graphindex aus mehreren Ebenen für die näherungsweise Suche nach nächsten Nachbarn.
28. Februar 2017: Jeff Johnson, Matthijs Douze und Hervé Jégou veröffentlichen „Billion-scale similarity search with GPUs“. Im März gibt Facebook die Bibliothek Faiss frei und schreibt, klassische, per SQL abgefragte Datenbanken seien für solche Vektoren nicht ausgelegt.
20. April 2021: erste Version von pgvector, einer Erweiterung, die PostgreSQL um Vektorsuche ergänzt.
28. August 2023: pgvector 0.5.0 bringt den Indextyp HNSW.
16. Januar 2024: Das Paper „The Faiss library“ nennt die Ähnlichkeitssuche „a core functionality of vector databases“.
30. Oktober 2024: pgvector 0.8.0 führt iterative Index-Scans ein, gedacht für Abfragen mit Filter.
Wie es funktioniert
Beim Schreiben werden Dokumente in Abschnitte (Chunks) zerlegt, ein Embedding-Modell macht aus jedem Abschnitt einen Vektor, und die Datenbank speichert ihn zusammen mit dem Text, oder einem Verweis darauf, und seinen Metadaten. Beim Abfragen läuft die Frage durch dasselbe Modell, und die Datenbank liefert die k nächsten Vektoren. Weaviate betont, dass Daten und Abfragen dasselbe Modell mit derselben Konfiguration nutzen müssen, weil die Vektoren nur dann vergleichbar sind.
Zwei Wege durch dasselbe Modell
Ablauf nach Weaviate
Beim Schreiben
Beim Abfragen
Dokumente
in Abschnitte (Chunks) zerlegt
Frage
dasselbe Embedding-Modell
mit derselben Konfiguration
Vektor + Text oder Verweis + Metadaten
speichert die Datenbank
die k nächsten Vektoren
Orange: Nur mit demselben Modell sind die Vektoren vergleichbar.
Wo müssen Schreiben und Abfragen übereinstimmen?
Die Frage mit jedem gespeicherten Vektor zu vergleichen, liefert das exakte Ergebnis, aber der Aufwand wächst mit der Zahl der Vektoren und ihren Dimensionen. Deshalb gibt es Indizes für die näherungsweise Suche (ANN, approximate nearest neighbor). HNSW baut mehrere Ebenen von Nachbarschaftsgraphen und beginnt die Suche auf der obersten. IVF teilt die Vektoren in Listen und durchsucht nur die Listen, die der Frage am nächsten liegen; laut pgvector-Dokumentation baut IVF schneller und braucht weniger Speicher als HNSW, bietet aber das schlechtere Verhältnis von Tempo zu Trefferquote. Quantisierung komprimiert die Vektoren und spart Speicher, meist auf Kosten der Genauigkeit.
Welches Distanzmaß passt (Kosinus, euklidische Distanz oder Skalarprodukt), hängt vom Embedding-Modell ab. Wie Ähnlichkeit gemessen wird, erklärt der Eintrag zu Embeddings.
Metadatenfilter greifen vor oder nach der Vektorsuche. Laut Pinecone verkleinert Vorfiltern den Suchraum, Nachfiltern berücksichtigt alle relevanten Treffer, und beides kann die Abfrage verlangsamen. Weaviate, MongoDB und pgvector kombinieren die Vektorsuche außerdem mit der Stichwortsuche (hybride Suche), was bei Produktnamen, Fehlercodes und Abkürzungen hilft.
Die näherungsweise Suche erkauft Tempo mit Trefferquote (Recall): Sie kann einige der tatsächlich nächsten Nachbarn übersehen. Die pgvector-Dokumentation warnt, dass dieselben Abfragen nach dem Anlegen eines näherungsweisen Index andere Ergebnisse liefern können.
Arten und Varianten
Weaviate teilt Werkzeuge mit Vektorsuche in drei Kategorien:
Art
Was es ist
Wann es passt
Eigenständige Vektordatenbank
System, das für das Speichern und Durchsuchen von Vektoren gebaut ist, mit eigener Persistenz, Filtern, Zugriffsrechten und Skalierung
Vektor- oder hybride Suche steht im Zentrum der Anwendung
Datenbank mit Vektorsuche
Bestehende Datenbank oder Suchmaschine mit Vektortypen und ANN-Indizes: PostgreSQL mit pgvector, MongoDB, Elasticsearch
Die Vektoren sollen neben den vorhandenen Transaktionsdaten liegen
Index-Bibliothek
Algorithmen und Datenstrukturen für die Nachbarsuche, ohne Datenbankfunktionen
Prototypen, Offline-Verarbeitung oder Teams mit eigener Speicherschicht
Quelle: Weaviate, „What Is a Vector Database?“, Abschnitt „Tool Landscape around Vector Databases“; Beispiele der zweiten Zeile aus der Dokumentation von pgvector, MongoDB und Elastic (abgerufen am 14.11.2026).
Ein Beispiel für eine Bibliothek ist Faiss. Das Projekt beschreibt sie als Bibliothek für effiziente Ähnlichkeitssuche und Clustering dichter Vektoren, geschrieben in C++ mit Python-Anbindung und vor allem in Metas Gruppe Fundamental AI Research entwickelt; laut Repository durchsucht sie auch Vektormengen, die womöglich nicht in den Arbeitsspeicher passen. Das Paper der Autoren zieht die Grenze: Faiss ist kein Dienst, weil seine Funktionen im Prozess der Anwendung laufen, und „is not a database“, weil es weder gleichzeitige Schreibzugriffe noch Lastverteilung, Sharding, Transaktionsverwaltung oder Abfrageoptimierung bietet. Laut demselben Paper nutzt Milvus Faiss als eine seiner Kern-Engines, und Pinecone stützte sich anfangs darauf, bevor es seine Engine in Rust neu schrieb.
Datenbanken lassen sich auf eigenen Servern betreiben oder als verwalteter Dienst buchen. Pinecone gibt es als verwalteten Dienst; Chroma, Milvus, Qdrant und Weaviate veröffentlichen ihren Code und bieten zusätzlich eine Cloud-Version an.
Beispiele
Einsatzfälle, die Weaviate, Elastic und MongoDB in ihrer Dokumentation beschreiben:
Textabschnitte für ein Sprachmodell abrufen, bei RAG.
Semantische Suche im Katalog eines Onlineshops oder in einem Hilfecenter.
Empfehlungen für Produkte oder Inhalte, die dem ähneln, was jemand schon angesehen hat.
Dubletten und Beinahe-Dubletten finden.
Bilder, Audio oder Videos nach Ähnlichkeit suchen.
Weaviate beschreibt einen Support-Assistenten, der erklären soll, wie man einen API-Schlüssel wechselt, ohne die Anwendung zu unterbrechen. Die Produktdokumentation liegt in kleinen Abschnitten vor, jeder mit seinem Vektor und Metadaten wie Produktversion und Zugriffsstufe. Die Vektorsuche findet Abschnitte über den Wechsel von Zugangsdaten, auch wenn sie andere Wörter verwenden, die Stichwortsuche sichert exakte Treffer für „API key“, und ein Filter lässt nur die Version des Kunden und die Dokumente übrig, die er sehen darf. Nur die bestplatzierten Abschnitte gehen an das Sprachmodell, mit der Anweisung, daraus zu antworten und die Quelle zu nennen.
Ein Beispiel aus der pgvector-Dokumentation zeigt, was ein Filter hinter einem näherungsweisen Index bewirkt. Die HNSW-Suche hält standardmäßig eine Kandidatenliste mit 40 Einträgen (Einstellung hnsw.ef_search), der Filter greift danach. Trifft die Bedingung auf 10 % der Zeilen zu, bleiben im Schnitt 4 Ergebnisse übrig. Seit Version 0.8.0 lesen iterative Index-Scans weiter, bis genug Ergebnisse vorliegen.
Vor- und Nachteile
Laut Weaviate lohnt sich eine eigene Vektordatenbank, wenn die Ähnlichkeitssuche zum Kern des Produkts gehört und Anforderungen aus dem Produktivbetrieb dazukommen: häufige Aktualisierungen, Filter nach Metadaten oder Rechten, viele gleichzeitige Nutzer, niedrige Latenz, hohe Verfügbarkeit oder große Datenmengen.
Unnötig sein kann sie, wenn die Daten klein und weitgehend unverändert sind, die Suche offline läuft oder die vorhandene Datenbank die Anforderungen schon erfüllt. Elastic empfiehlt für kleine Datenmengen die exakte kNN-Suche ohne näherungsweisen Index, und pgvector sucht exakt, solange kein Index angelegt ist. Mit pgvector liegen die Vektoren bei den übrigen Daten und behalten die ACID-Transaktionen und JOINs von PostgreSQL.
Weaviate fasst die Abwägung so zusammen: Die vorhandene Datenbank vereinfacht Betrieb und Datenkonsistenz, ein eigenständiges System kann umfangreichere Suchfunktionen oder planbarere Leistung bieten, wenn die Vektorsuche die Hauptlast ist.
Abgrenzung zu verwandten Begriffen
System
Sucht nach
Typische Abfrage
Stärke
Relationale Datenbank
Exakten Werten in Spalten
Bestellungen eines Kunden zwischen zwei Daten
Strukturierte Daten, Transaktionen, Joins
Volltextsuche
Wörtern, die im Text vorkommen
Dokumente, die „rote Frucht“ enthalten
Exakte Begriffe: Produktnamen, Codes, Abkürzungen
Graphdatenbank
Beziehungen zwischen Knoten
Personen, die mit einer bestimmten Person verbunden sind
Verbindungen und Muster in Netzwerken
Vektordatenbank
Nähe zwischen Vektoren
Rote Früchte, auch wenn im Text „Erdbeeren“ steht
Synonyme, Umschreibungen, Bildsuche
Quelle: Weaviate, „What Is a Vector Database?“, Vergleiche mit relationalen und Graphdatenbanken; MongoDB, „MongoDB Vector Search Overview“, Beispiel „red fruit“; pgvector, Funktionen von PostgreSQL (abgerufen am 14.11.2026).
Die Grenze zur relationalen Datenbank hat sich verschoben, weil PostgreSQL, MongoDB und Elasticsearch inzwischen ebenfalls Vektoren durchsuchen. Laut Weaviate hebt sich ein eigenständiges System durch spezialisierte Indizes, Filter, Mandantenfähigkeit, Kompression und verteilte Skalierung ab.
„Vector store“ ist laut Weaviate ein weiter gefasster Begriff, den KI-Frameworks für die Schnittstelle zu beliebigen Vektorsuch-Systemen verwenden; „vector database“ meint meist ein vollständiges System mit Persistenz, Filtern, Sicherheit und Skalierung. Keiner der beiden Begriffe ist genormt.
Werkzeuge
Produkte und Projekte mit Vektorsuche, alphabetisch, ohne Rangfolge.
Werkzeug
Art, laut Hersteller
Lizenz oder Modell
Chroma
Suchinfrastruktur für KI: Vektor-, Volltext- und Metadatensuche
Open Source (Apache 2.0); auch als Cloud-Dienst
Elasticsearch
Suchmaschine mit exakter und näherungsweiser kNN-Suche
Elastic License 2.0; Quellcode auch unter AGPLv3 oder SSPL
Faiss
Bibliothek für Ähnlichkeitssuche (Meta)
Open Source (MIT)
Milvus
Vektordatenbank
Open Source (Apache 2.0); verwalteter Dienst bei Zilliz Cloud
MongoDB Vector Search
Vektorsuche in MongoDB
Cluster in MongoDB Atlas und lokale Installationen über die Atlas CLI
pgvector
Erweiterung für PostgreSQL
Open Source (Lizenz nach Art der PostgreSQL-Lizenz)
Pinecone
Serverlose Vektordatenbank
Kommerzieller verwalteter Dienst
Qdrant
Vektorsuchmaschine und Vektordatenbank
Open Source (Apache 2.0); auch als Cloud-Dienst
Weaviate
Vektordatenbank
Open Source (BSD-3-Clause), Enterprise-Funktionen gesondert lizenziert; auch als Cloud-Dienst
Quelle: Produktseiten, Repositorys und Dokumentation der Hersteller (abgerufen am 14.11.2026).
Kritik und Grenzen
Trefferquoten, die Hersteller veröffentlichen, sind deren Angabe. Weaviate schreibt, in internen Tests habe die 8-Bit-Quantisierung RQ etwa 98 bis 99 % der Trefferquote gehalten, bei bis zu 4-facher Kompression, und rät, das mit eigenen Daten zu messen.
Ein ähnlicher Text ist noch keine richtige Antwort. Weaviate räumt ein, dass eine Vektordatenbank Halluzinationen eines Sprachmodells nicht von sich aus verhindert. Warum Embeddings mit Verneinung schlecht umgehen, erklärt der Eintrag zu Embeddings.
Die Kategorien überlappen: Weaviate nennt seine eigenen Tendenzen, „not guarantees“, mit Grenzen, die „increasingly blurred“ seien. Pinecone, selbst Anbieter einer Vektordatenbank, schreibt, eigenständigen Indizes, darunter FAISS, fehlten Funktionen jeder Datenbank, und sie müssten für neue Daten womöglich komplett neu indexiert werden. Das Faiss-Paper schränkt das ein: Die Faiss-API löscht und ändert Vektoren über ihre ID, der HNSW-Index von Faiss erlaubt aber weder Löschen noch Ändern, und IVF- und PQ-Indizes verlieren an Effizienz, wenn sich die Verteilung der Daten stark verschiebt. Metadaten speichert Faiss nicht; gefiltert wird über eine Funktion, die die ID jedes Vektors erhält.
Wer das Embedding-Modell wechselt, muss alle Vektoren neu berechnen. Und teilen sich mehrere Mandanten einen näherungsweisen Index, können laut pgvector die Vektoren des einen Trefferquote und Tempo der anderen beeinflussen.
So gehst du Schritt für Schritt vor
Prüfe, ob deine vorhandene Datenbank Vektorsuche anbietet.
Lege das Embedding-Modell fest und halte Modell und Konfiguration bei den Daten fest.
Zerlege die Dokumente in Abschnitte und speichere jeden Vektor mit Text und Metadaten.
Starte mit exakter Suche, solange die Sammlung klein ist, und lege einen näherungsweisen Index an, wenn die Latenz es verlangt.
Miss die Trefferquote mit echten Fragen, indem du näherungsweise und exakte Ergebnisse vergleichst.
Plane die Neuberechnung aller Vektoren, bevor du das Modell wechselst.
Best Practices
Kombiniere Vektor- und Stichwortsuche, wenn Produktnamen, Codes oder Abkürzungen zählen.
Nutze das Distanzmaß, das der Anbieter des Embedding-Modells empfiehlt.
Trenne Mandanten über Partitionen oder eigene Tabellen, statt einen näherungsweisen Index zu teilen.
Häufige Fehler
Vektoren aus verschiedenen Modellen im selben Index mischen.
Hinter einem näherungsweisen Index filtern, ohne zu prüfen, wie viele Ergebnisse übrig bleiben.
Eine Leistungszahl eines Herstellers übernehmen, ohne sie mit eigenen Daten zu messen.
Ähnlichkeit zwischen Texten als Beweis nehmen, dass eine Antwort stimmt.
Wie dieser Eintrag entstanden ist
Dieser Eintrag wurde im November 2026 mit Hilfe von KI geschrieben. Die Angaben stammen aus den Papern zu HNSW und Faiss auf arXiv, der Faiss-Vorstellung von 2017, dem pgvector-Repository sowie aus Dokumentation und Produktseiten der Hersteller. Er wurde vor der Veröffentlichung geprüft und enthält keine Kundendaten.
Manuel Riveiro RodriguezCEO & Digital Strategist
Eine technische Prüfung sieht sich das und alles Weitere in einem Durchgang an.
Was ist eine Vektordatenbank und wofür braucht man sie?
Eine Datenbank, die Vektoren (Embeddings) speichert und die einer Anfrage ähnlichsten zurückgibt. Sie dient der semantischen Suche, Empfehlungen und dazu, einem Sprachmodell bei RAG Kontext zu liefern.
Was ist der Unterschied zwischen einer Vektordatenbank und einer relationalen Datenbank?
Die relationale Datenbank sucht exakte Werte in Spalten; die Vektordatenbank sucht nach Nähe zwischen Vektoren und findet ähnliche Texte, auch wenn sie andere Wörter verwenden. PostgreSQL mit pgvector kann beides.
Ist FAISS eine Vektordatenbank?
Nein. Das Paper der Autoren sagt es ausdrücklich: Faiss „is not a database“, weil es weder gleichzeitige Schreibzugriffe noch Sharding oder Transaktionsverwaltung bietet. Es ist eine Index-Bibliothek, die in der Anwendung läuft, und manche Vektordatenbanken nutzen sie als Engine.
Welche Vektordatenbanken gibt es?
Unter anderem Chroma, Milvus, Pinecone, Qdrant und Weaviate als eigenständige Systeme sowie Elasticsearch, MongoDB und PostgreSQL mit pgvector als bestehende Systeme mit Vektorsuche. Die Werkzeugtabelle nennt Art und Lizenz.
Braucht man für RAG eine Vektordatenbank?
Nicht immer. Weaviate, selbst Anbieter einer solchen, schreibt, kleine oder statische RAG-Anwendungen kämen mit einem Index im Arbeitsspeicher oder der Vektorsuche einer vorhandenen Datenbank aus.