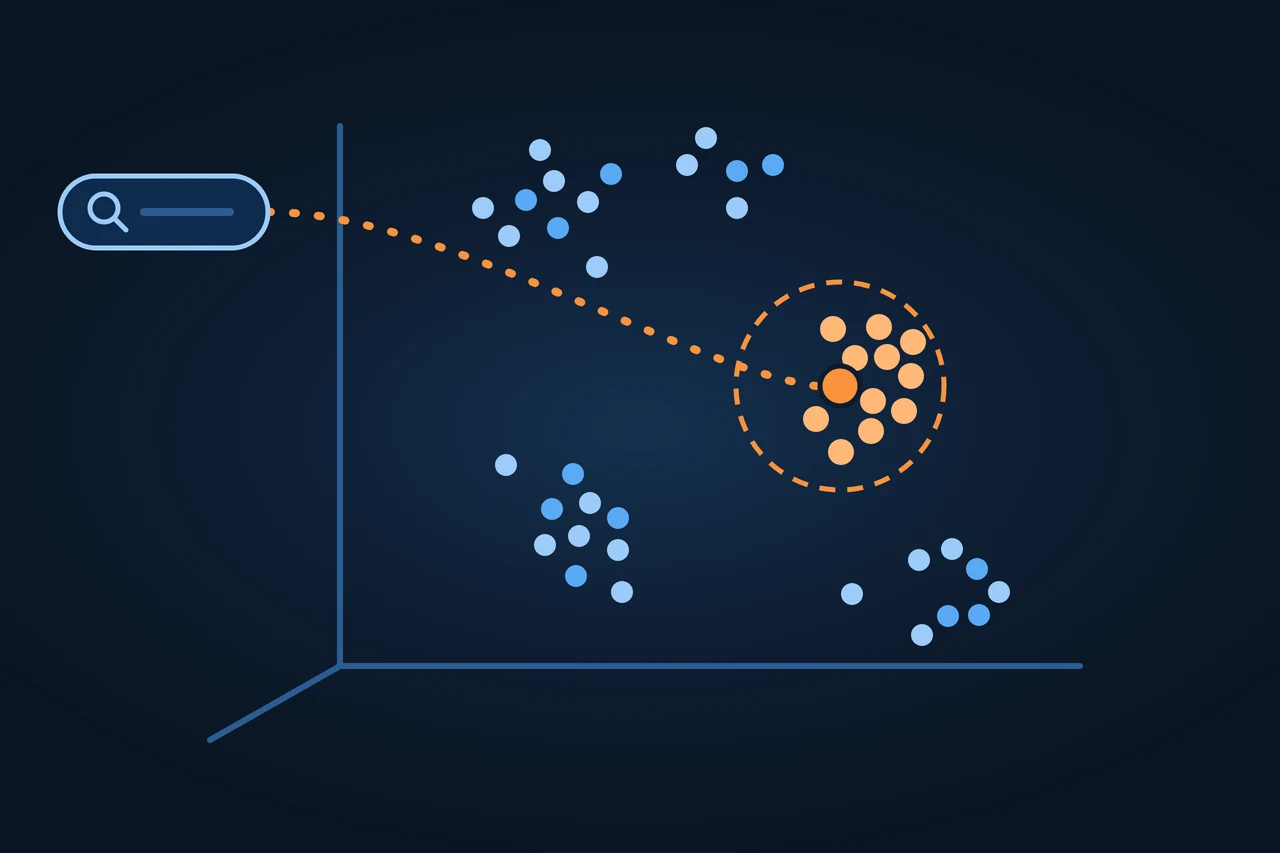
Una base de datos vectorial (en inglés, vector database) guarda vectores, normalmente embeddings de textos, imágenes o audio, y los busca por parecido en lugar de por valores exactos. Weaviate la define como un sistema de datos diseñado para almacenar, indexar y consultar embeddings. Según Weaviate y Pinecone, a la búsqueda por parecido añade funciones de cualquier base de datos: insertar, actualizar y borrar datos, filtrar por metadatos y controlar el acceso.
Una base de datos vectorial guarda embeddings y busca por parecido. Cómo funciona, en qué se diferencia de un índice y cuándo no hace falta.
Historia y evolución
La técnica en la que se apoya tiene estas fechas:
30 de marzo de 2016: Yu. A. Malkov y D. A. Yashunin publican en arXiv HNSW, un índice de grafos por capas para la búsqueda aproximada de vecinos más cercanos.
28 de febrero de 2017: Jeff Johnson, Matthijs Douze y Hervé Jégou publican «Billion-scale similarity search with GPUs». En marzo, Facebook libera la biblioteca Faiss y escribe que las bases de datos consultadas con SQL no están adaptadas a estos vectores.
20 de abril de 2021: primera versión de pgvector, una extensión que añade búsqueda vectorial a PostgreSQL.
28 de agosto de 2023: pgvector 0.5.0 incorpora el índice HNSW.
16 de enero de 2024: el artículo «The Faiss library» llama a la búsqueda de similitud «a core functionality of vector databases».
30 de octubre de 2024: pgvector 0.8.0 añade los recorridos iterativos del índice, pensados para consultas con filtro.
Cómo funciona
Al escribir, los documentos se dividen en fragmentos, un modelo de embedding convierte cada uno en un vector y la base de datos lo guarda junto con el texto, o una referencia a él, y sus metadatos. Al consultar, la pregunta pasa por el mismo modelo y la base de datos devuelve los k vectores más cercanos. Según Weaviate, datos y consultas deben usar el mismo modelo y la misma configuración, porque solo así los vectores son comparables.
Dos caminos por el mismo modelo
Proceso según Weaviate
Al escribir
Al consultar
Documentos
divididos en fragmentos
Pregunta
el mismo modelo de embedding
con la misma configuración
Vector + texto o referencia + metadatos
guardados en la base de datos
los k vectores más cercanos
En naranja: solo con el mismo modelo los vectores son comparables.
¿Dónde tienen que coincidir la escritura y la consulta?
Comparar la pregunta con cada vector da el resultado exacto, pero el trabajo crece con el número de vectores y sus dimensiones. Por eso se usan índices de búsqueda aproximada (ANN). HNSW construye varias capas de grafos de proximidad y empieza a buscar por la superior. IVF reparte los vectores en listas y solo revisa las más cercanas a la pregunta; según pgvector, se construye más rápido y ocupa menos memoria que HNSW, con peor relación entre velocidad y acierto. La cuantización comprime los vectores y ahorra memoria, en general a costa de precisión.
Qué medida de distancia conviene (coseno, distancia euclídea o producto escalar) depende del modelo. Cómo se mide el parecido lo explica la entrada sobre embeddings.
Los filtros por metadatos se aplican antes o después de la búsqueda vectorial. Según Pinecone, filtrar antes reduce el espacio de búsqueda, filtrar después tiene en cuenta todos los resultados relevantes y las dos opciones pueden ralentizar la consulta. Weaviate, MongoDB y pgvector combinan además la búsqueda vectorial con la búsqueda por palabras clave (búsqueda híbrida), útil para nombres de producto, códigos de error o siglas.
La búsqueda aproximada paga la velocidad con acierto (recall): puede dejar fuera vecinos que sí eran de los más cercanos. pgvector advierte de que, tras añadir un índice aproximado, las mismas consultas pueden dar resultados distintos.
Tipos y variantes
Weaviate distingue tres categorías de herramientas con búsqueda vectorial:
Tipo
Qué es
Cuándo encaja
Base de datos vectorial dedicada
Sistema hecho para guardar y buscar vectores, con persistencia, filtros, control de acceso y escalado
La búsqueda vectorial o híbrida es el centro de la aplicación
Base de datos con búsqueda vectorial
Base de datos o buscador existente con tipos vectoriales e índices ANN: PostgreSQL con pgvector, MongoDB, Elasticsearch
Los vectores deben estar junto a los datos que ya existen
Biblioteca de indexación
Algoritmos y estructuras para buscar vecinos, sin funciones de base de datos
Prototipos, procesos fuera de línea o equipos con su propia capa de almacenamiento
Fuente: Weaviate, «What Is a Vector Database?», apartado «Tool Landscape around Vector Databases»; ejemplos de la segunda fila según la documentación de pgvector, MongoDB y Elastic (consultados el 14.11.2026).
Un ejemplo de biblioteca es Faiss. Su proyecto la describe como una biblioteca para la búsqueda eficiente de similitud y el agrupamiento de vectores densos, escrita en C++ con interfaz para Python y desarrollada sobre todo en el grupo de investigación de IA de Meta; según el repositorio, busca incluso en conjuntos que pueden no caber en la memoria RAM. El artículo de sus autores marca el límite: Faiss no es un servicio, porque sus funciones corren dentro del proceso de la aplicación, y «is not a database», porque no ofrece escritura concurrente, balanceo de carga, sharding, gestión de transacciones ni optimización de consultas. Según el mismo artículo, Milvus usa Faiss como uno de sus motores y Pinecone se apoyó en él al principio, antes de reescribir su motor en Rust.
Las bases de datos se pueden operar en servidores propios o contratar como servicio gestionado. Pinecone se ofrece como servicio; Chroma, Milvus, Qdrant y Weaviate publican su código y tienen además una versión en la nube.
Ejemplos
Usos que describen Weaviate, Elastic y MongoDB en su documentación:
Recuperar fragmentos de documentos para un modelo de lenguaje en RAG.
Búsqueda semántica en el catálogo de una tienda o en un centro de ayuda.
Recomendaciones de productos o contenidos parecidos a los que ya vio una persona.
Detección de duplicados y casi duplicados.
Búsqueda de imágenes, audio o vídeo por parecido.
Weaviate documenta un asistente de soporte que debe explicar cómo cambiar una clave de API sin interrumpir la aplicación. La documentación del producto se guarda en fragmentos pequeños, cada uno con su vector y con metadatos como versión del producto y nivel de acceso. La búsqueda vectorial encuentra fragmentos sobre cambiar credenciales aunque usen otras palabras, la búsqueda por palabras clave asegura las coincidencias exactas con «API key» y un filtro deja solo la versión del cliente y los documentos que puede ver. Los fragmentos mejor situados llegan al modelo de lenguaje con la instrucción de responder a partir de ellos y citar la fuente.
Un ejemplo de pgvector muestra lo que hace un filtro detrás de un índice aproximado. La lista de candidatos de la búsqueda HNSW tiene por defecto 40 entradas (parámetro hnsw.ef_search) y el filtro se aplica después. Si la condición solo la cumple el 10 % de las filas, quedan de media 4 resultados. Desde la versión 0.8.0, los recorridos iterativos siguen leyendo el índice hasta reunir suficientes.
Ventajas y desventajas
Según Weaviate, una base de datos vectorial propia compensa cuando la búsqueda por parecido es central en el producto y hay requisitos de producción: actualizaciones frecuentes, filtros por metadatos o permisos, muchos usuarios a la vez, baja latencia, alta disponibilidad o grandes volúmenes.
Puede no hacer falta si los datos son pocos y apenas cambian, si la búsqueda se hace fuera de línea o si la base de datos actual ya cumple. Elastic recomienda la búsqueda kNN exacta, sin índice aproximado, para conjuntos pequeños, y pgvector busca de forma exacta mientras no se cree un índice. Con pgvector, los vectores se guardan con el resto de los datos y conservan las transacciones ACID y las uniones (JOIN) de PostgreSQL.
Weaviate resume el equilibrio así: la base de datos existente simplifica la operación y la coherencia de los datos; un sistema dedicado puede dar funciones de búsqueda más completas o un rendimiento más predecible si la búsqueda vectorial es la carga principal.
Diferencias con otros conceptos
Sistema
Busca por
Consulta típica
Punto fuerte
Base de datos relacional
Valores exactos en columnas
Pedidos de un cliente entre dos fechas
Datos estructurados, transacciones, uniones
Búsqueda de texto completo
Palabras que aparecen en el texto
Documentos que contienen «fruta roja»
Términos exactos: nombres de producto, códigos, siglas
Base de datos de grafos
Relaciones entre nodos
Personas conectadas con una persona dada
Conexiones y patrones en redes
Base de datos vectorial
Cercanía entre vectores
Frutas rojas, aunque el texto diga «fresas»
Sinónimos, paráfrasis, búsqueda en imágenes
Fuente: Weaviate, «What Is a Vector Database?», comparaciones con bases de datos relacionales y de grafos; MongoDB, «MongoDB Vector Search Overview», ejemplo de «red fruit»; pgvector, funciones de PostgreSQL (consultados el 14.11.2026).
La frontera con la base de datos relacional se ha movido, porque PostgreSQL, MongoDB y Elasticsearch ya buscan vectores. Según Weaviate, el sistema dedicado se distingue por sus índices, filtros, multiinquilino, compresión y escalado distribuido.
«Vector store» (almacén de vectores) es, según Weaviate, un término más amplio que usan los frameworks de IA para la interfaz con cualquier sistema de búsqueda vectorial; «vector database» suele implicar un sistema completo con persistencia, filtros, seguridad y escalado. Ninguno de los dos términos está normalizado.
Herramientas
Productos y proyectos con búsqueda vectorial, en orden alfabético, sin clasificación.
Herramienta
Tipo, según el fabricante
Licencia o modelo
Chroma
Búsqueda para IA: vectorial, texto completo y metadatos
Código abierto (Apache 2.0); también en la nube
Elasticsearch
Motor de búsqueda con búsqueda kNN exacta y aproximada
Elastic License 2.0; código fuente también bajo AGPLv3 o SSPL
Faiss
Biblioteca de búsqueda de similitud (Meta)
Código abierto (MIT)
Milvus
Base de datos vectorial
Código abierto (Apache 2.0); servicio gestionado en Zilliz Cloud
MongoDB Vector Search
Búsqueda vectorial dentro de MongoDB
Clústeres de MongoDB Atlas y despliegues locales con Atlas CLI
pgvector
Extensión de PostgreSQL
Código abierto (licencia de estilo PostgreSQL)
Pinecone
Base de datos vectorial serverless
Servicio comercial gestionado
Qdrant
Motor de búsqueda y base de datos vectorial
Código abierto (Apache 2.0); también en la nube
Weaviate
Base de datos vectorial
Código abierto (BSD-3-Clause), funciones empresariales aparte; también en la nube
Fuente: páginas de producto, repositorios y documentación de cada fabricante (consultados el 14.11.2026).
Críticas y límites
Las cifras de acierto que publican los fabricantes son suyas. Weaviate escribe que en sus pruebas internas la cuantización RQ de 8 bits conservó aproximadamente entre el 98 y el 99 % del acierto con una compresión de hasta 4 veces, y pide medirlo con datos propios.
Que dos textos se parezcan no significa que la respuesta sea correcta. Weaviate reconoce que una base de datos vectorial no evita por sí sola las alucinaciones de un modelo de lenguaje. Por qué los embeddings tratan mal la negación lo explica la entrada sobre embeddings.
Las categorías se solapan: Weaviate presenta las suyas como tendencias, «not guarantees», con límites «increasingly blurred». Pinecone, que vende una base de datos vectorial, sostiene que a los índices independientes, entre los que cita FAISS, les faltan funciones de cualquier base de datos y que pueden necesitar una reindexación completa para incorporar datos nuevos. El artículo de Faiss lo matiza: su API borra y actualiza vectores por identificador, pero su índice HNSW no admite borrados ni cambios, y los índices IVF y PQ pierden eficiencia si la distribución de los datos cambia mucho. Faiss tampoco guarda metadatos; filtra con una función que recibe el identificador de cada vector.
Cambiar de modelo de embedding obliga a recalcular todos los vectores. Y si varios clientes comparten un índice aproximado, según pgvector los vectores de uno pueden afectar al acierto y la velocidad de los demás.
Cómo se aplica paso a paso
Comprueba si la base de datos que ya usas ofrece búsqueda vectorial.
Elige el modelo de embedding y anota modelo y configuración junto a los datos.
Divide los documentos en fragmentos y guarda cada vector con su texto y sus metadatos.
Empieza con búsqueda exacta mientras la colección sea pequeña y añade un índice aproximado cuando la latencia lo pida.
Mide el acierto con preguntas reales, comparando los resultados aproximados con los exactos.
Planifica la regeneración de todos los vectores antes de cambiar de modelo.
Buenas prácticas
Combina búsqueda vectorial y por palabras clave cuando importan nombres de producto, códigos o siglas.
Usa la medida de distancia que recomienda el proveedor del modelo de embedding.
Separa a los clientes con particiones o tablas propias en lugar de compartir un índice aproximado.
Errores frecuentes
Mezclar en un mismo índice vectores de modelos distintos.
Filtrar detrás de un índice aproximado sin comprobar cuántos resultados quedan.
Dar por buena una cifra de rendimiento de un fabricante sin medirla con datos propios.
Tomar el parecido entre textos como prueba de que la respuesta es correcta.
Cómo se hizo esta entrada
Esta entrada se redactó en noviembre de 2026 con ayuda de IA. Los datos proceden de los artículos de HNSW y Faiss en arXiv, de la presentación de Faiss de 2017, del repositorio de pgvector y de la documentación y las páginas de los fabricantes. Se revisó antes de publicarse y no contiene datos de clientes.
Manuel Riveiro RodriguezCEO & Digital Strategist
Una auditoría técnica revisa esto y el resto en un solo paso.
¿Qué es una base de datos vectorial y para qué sirve?
Una base de datos que guarda vectores (embeddings) y devuelve los más parecidos a una consulta. Sirve para búsqueda semántica, recomendaciones y para dar contexto a un modelo de lenguaje en RAG.
¿Qué diferencia hay entre una base de datos vectorial y una relacional?
La relacional busca valores exactos en columnas; la vectorial busca por cercanía entre vectores y encuentra textos parecidos aunque usen otras palabras. PostgreSQL con pgvector hace ambas cosas.
¿Es FAISS una base de datos vectorial?
No. El artículo de sus autores lo dice expresamente: Faiss «is not a database», porque no ofrece escritura concurrente, sharding ni gestión de transacciones. Es una biblioteca de índices que corre dentro de la aplicación, y algunas bases de datos vectoriales la usan como motor.
¿Qué bases de datos vectoriales existen?
Entre otras, Chroma, Milvus, Pinecone, Qdrant y Weaviate como sistemas dedicados, y Elasticsearch, MongoDB y PostgreSQL con pgvector como sistemas existentes con búsqueda vectorial. La tabla de herramientas recoge tipo y licencia.
¿Hace falta una base de datos vectorial para RAG?
No siempre. Weaviate, que vende una, escribe que una aplicación RAG pequeña o con datos estables puede usar un índice en memoria o la búsqueda vectorial de una base de datos existente.